 中国香港服务器
 日本服务器
 美国服务器
 新加坡服务器

 推荐文章
Copyright © 2015-2026 HONG KONG COMMUNICATIONS INTERNATIONAL CO.,LIMITED.
香港联合通讯国际有限公司
智能DNS故障自动切换:服务器宕机如何秒级切换备份IP!
服务器宕机这件事,没有“会不会”,只有“什么时候”。香港CN2 VPS也好,美国大带宽服务器也好,再贵的机器也有出故障的一天。问题不在于“如何避免宕机”,而在于“宕机之后,用户多久能恢复访问”。如果你只有一台服务器,宕机就是彻底不可用,用户只能干等。但如果你有主备两台服务器,并且配置了智能DNS故障自动切换,理论上可以在几十秒内把用户流量从故障的主机切到备份机上。
先搞清楚:DNS切换为什么“快不了”
在聊智能DNS之前,必须先理解一个反直觉的事实:普通DNS解析的故障切换,最慢可能要等几个小时甚至几天。
原因在于DNS的缓存机制。当你把域名的A记录从主服务器IP改成备份服务器IP,权威DNS服务器确实立刻返回了新的IP。但问题在于,用户本地的递归DNS服务器(比如运营商的LocalDNS、路由器的DNS、公司内网的DNS)会缓存之前的解析结果。这个缓存的存活时间由TTL决定。
如果TTL设的是3600秒(1小时),那意味着最坏情况下,一个用户的递归DNS要等1小时才会去权威服务器重新查询。在这1小时里,他访问的还是已经宕机的主服务器IP,网站一直打不开。有技术分析指出,如果TTL设成2天,用户甚至可能持续2天无法访问。TTL越长,缓存越“顽固”,故障恢复越慢。
所以,“秒级切换”的核心挑战不是“改解析记录”这个动作本身,而是如何让用户端的DNS缓存尽快失效、尽快拿到新IP。
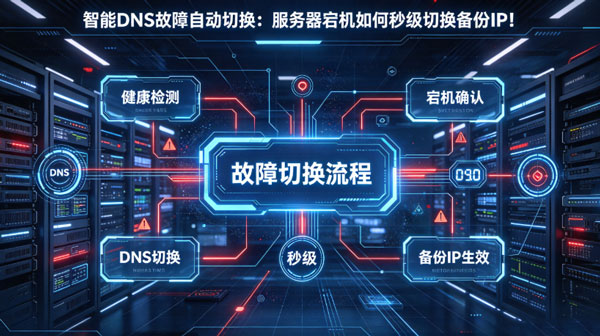
智能DNS故障切换的工作原理
智能DNS(也叫全局流量管理,GTM/GSLB)在普通DNS的基础上加了两样东西:健康检查和地址池切换逻辑。
健康检查是核心。GTM会从多个探测节点持续向你的服务器IP发起探测(ping、TCP端口、HTTP请求等),判断它是否“活着”。如果主IP连续几次探测失败,GTM就判定它不可用。
地址池切换是动作。当主IP被判定为故障,GTM会立即在权威DNS层面把解析结果从主IP改为备份IP。你不需要手动操作,整个过程自动完成。
你可以创建一个“主地址池”和一个“备地址池”,主地址池里放主服务器IP,备地址池里放备份机IP。在访问策略中设置“主地址池集合”和“备地址池集合”,并开启自动切换。当健康检查发现主地址池整体不可用时,系统自动将用户流量切到备地址池。
“秒级”到底能有多快?
宣传里的“秒级切换”需要拆开看,它由三个时间段组成:
故障发现时间:健康检查探测到异常需要多久?这取决于探测间隔和失败阈值。旗舰版探测间隔可以做到15秒,标准版是1分钟。如果设置“连续2次失败才判定故障”,那最快30秒发现,标准版则要2分钟。
切换执行时间:发现故障后,修改权威DNS记录、把流量切到备用IP,这个过程很快,通常在1到15秒内完成。
缓存扩散时间:这是最不可控的一段。权威DNS已经返回了新IP,但用户本地的递归DNS可能还在用旧缓存。这段等待时间完全取决于你设置的TTL值。
所以,“秒级切换”的前提是把TTL设得很短。行业建议的合理范围是30到60秒——太短会增加DNS查询负载,太长则切换变慢。
即便TTL设了30秒,用户端的体验也不是“30秒后立刻恢复”。有分析指出,TTL到期后,部分用户的客户端或应用层还有自己的重试和缓存逻辑,完全恢复可能需要几分钟。但对于“网站打不开”这个场景来说,30秒TTL配合GTM的健康检查,已经能把中断时间从“几小时”压缩到“几分钟以内”了。
配置流程(以主流云平台为例)
虽然各平台操作界面不同,但核心逻辑一致:创建地址池 → 配置健康检查 → 设置主备切换策略 → 接入域名。
第一步:创建地址池
在GTM控制台创建两个地址池:一个放主服务器IP,一个放备份服务器IP。地址池是“一组提供相同服务的IP的集合”,你可以把多个IP放进同一个池里实现负载均衡,也可以分开做主备。
第二步:配置健康检查
这是最关键的一步。给地址池里的每个IP配置探测方式:
探测协议:根据你的服务类型选。Web服务用HTTP/HTTPS,数据库或SSH用TCP,纯网络连通性用ping。
探测路径:如果选HTTP,可以指定一个健康检查专用的URL路径(比如/health),返回200就算正常。
探测间隔和失败阈值:间隔越短发现越快,但会增加探测负载。旗舰版可以做到15秒间隔,标准版1分钟。
第三步:设置切换策略
在访问策略中,把主地址池设为“主地址池集合”,备份地址池设为“备地址池集合”。切换策略必须选“自动切换”——有些平台默认是“仅暂停不切换”或“仅监控不切换”,这样故障时不会自动切到备份。
还有一个细节:地址池健康状态判定条件。你可以设置“地址池内至少1个地址可用”就算池健康,也可以设置“必须所有地址都可用”才算健康。前者更宽容,适合池内有多台冗余服务器的场景。
第四步:接入域名
GTM会给你一个CNAME接入域名。你需要回到域名的权威DNS解析设置里,把原来的A记录(直接指向IP)改成CNAME记录,指向GTM的接入域名。
这一步之后,用户的DNS查询会先到GTM,由GTM根据健康状态决定返回哪个IP。
常见错误和注意事项
TTL设得太长。这是最常见的错误。如果TTL是3600秒,GTM发现故障后改了权威记录,用户端最坏要等1小时才生效,“秒级切换”变成“小时级”。把TTL设成30-60秒是前提。
忘了开启“自动切换”。有些平台的容灾策略默认是“仅监控不切换”,配置完之后健康检查在跑、告警在发,但流量根本没切过去。
备份IP本身也不可用。GTM只负责切换,不负责保证备份机是好的。备份服务器需要独立维护,定期验证它能正常提供服务。
DNS本身也需要高可用。如果权威DNS服务器挂了,所有解析都失效。商业GTM通常有Anycast和多个冗余节点保障DNS自身的可用性。
智能DNS故障自动切换的“秒级”能力,70%取决于你把TTL设得多短,30%取决于GTM的探测和切换速度。配置流程本身不复杂:创建主备地址池、配好健康检查、开启自动切换、把域名CNAME到GTM。真正需要留意的是那些“看起来配了但实际没生效”的细节——切换策略是不是自动、TTL是不是够短、备份IP是不是真的活着。对于有营收的业务,这笔投入是值得的。宕机一小时的损失,可能远超GTM服务一年的费用。